Mein eigenes Portainer – samt Agenten – an einem Tag mit KI gebaut
Mein Homelab besteht aus einem Proxmox-Host, einem Docker-Host und einem wachsenden Haufen Container: ein paar Dienste, die ich selbst baue, viele öffentliche Images, statische Seiten, ein Datenbank-Cluster. Portainer zeigte mir Container an, wusste aber nichts über mein Setup – welcher Hostname öffentlich ist und welcher nur im LAN, welcher Container zu welchem Git-Repo gehört, wann zuletzt deployt wurde, ob ein Backend gerade überhaupt gebraucht wird.
Also habe ich mir das Dashboard gebaut, das ich eigentlich wollte. Der erste Commit entstand mittags; abends lief es produktiv, mit rund 6.700 Zeilen JavaScript, CSS und HTML, 26 Tests und ohne Datenbank. Den Code habe ich fast nicht selbst geschrieben – ich habe Ergebnisse beschrieben, die KI hat sie gebaut und geprüft, und mehrere KI-Agenten haben parallel gearbeitet. Dieser Beitrag zeigt, was dabei herausgekommen ist, wie die Arbeit ablief und was unterwegs schiefging. (Alle Screenshots stammen aus einem Demo-Modus mit erfundenen Daten – keine meiner echten Anwendungen ist darauf zu sehen.)
Was es kann
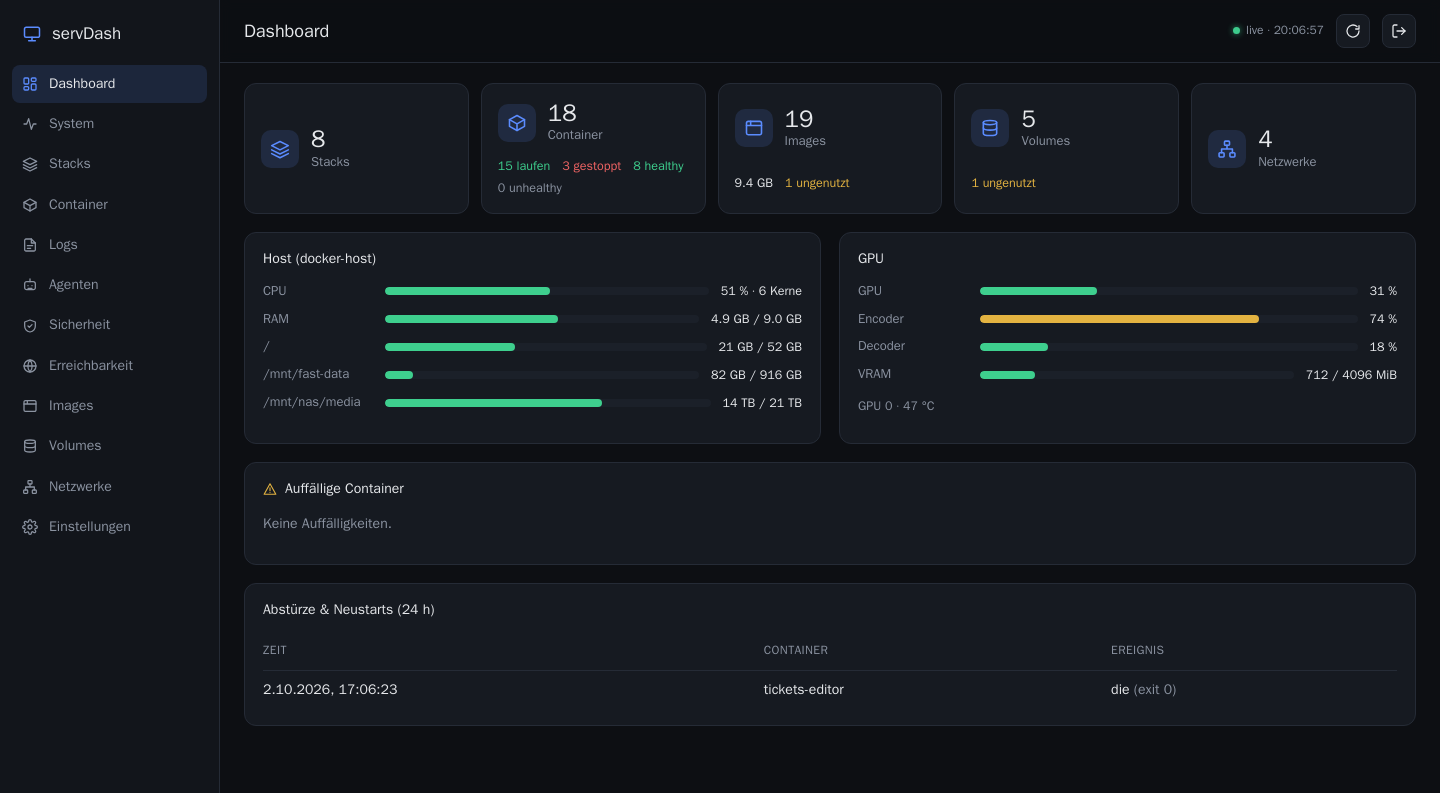
Ein Dashboard, das den Host kennt. CPU, Arbeitsspeicher, Platten (schnell und langsam), GPU und alles, was in den letzten 24 Stunden abgestürzt ist – auf einen Blick und live aktualisiert.
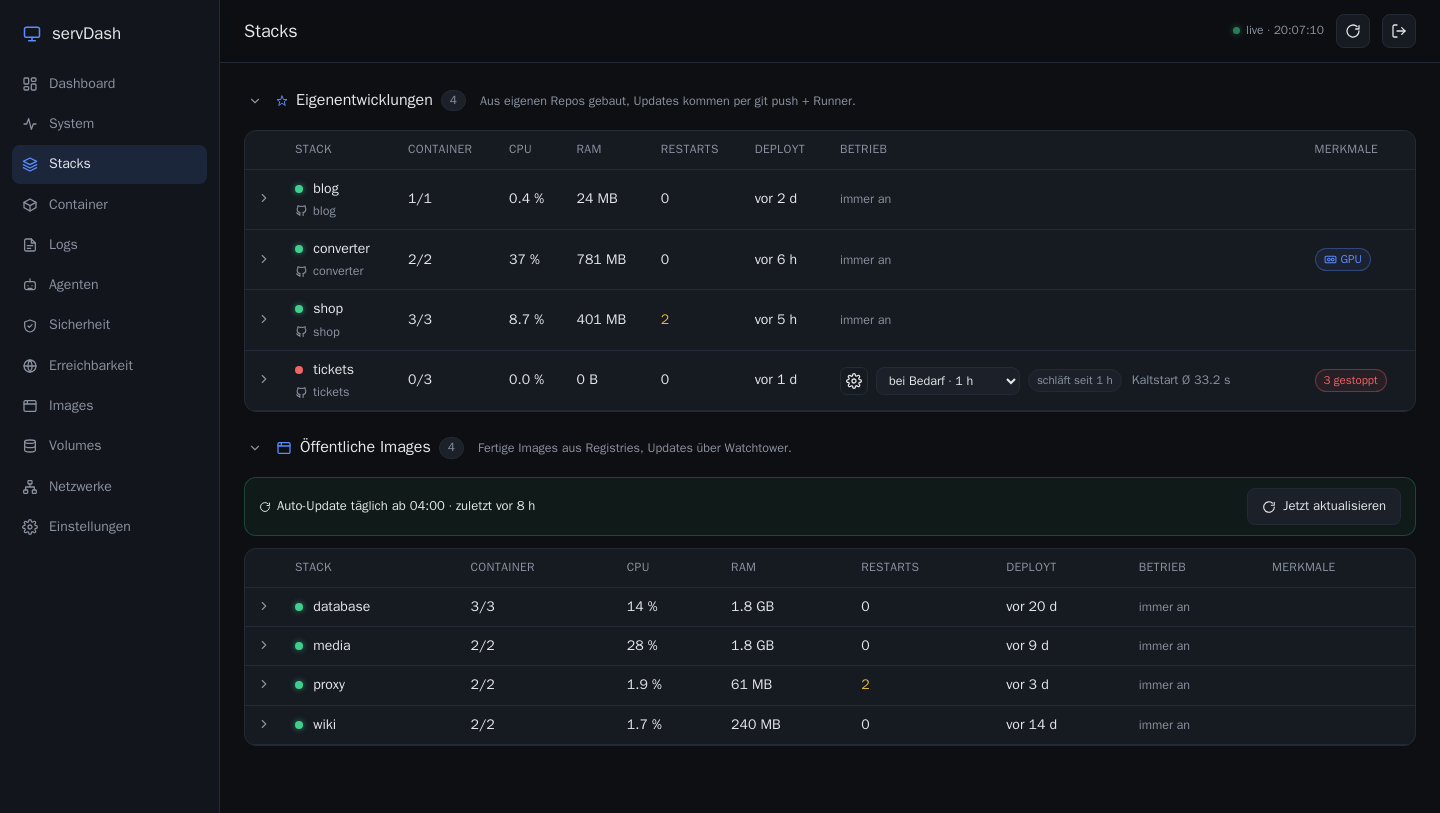
Stacks und Container, sortiert danach, wie sie gepflegt werden. Selbst Gebautes ist von öffentlichen Images getrennt. Öffentliche Images bekommen einen Auto-Update-Schalter pro Image (ein nächtlicher Job bittet Watchtower, genau die Images zu aktualisieren, die ich aktiviert habe). Jeder Stack verlinkt sein Git-Repo und zeigt, wann zuletzt deployt wurde. Start, Stop, Neustart und ein 48-Stunden-Log-Viewer mit Export sind einen Klick entfernt.
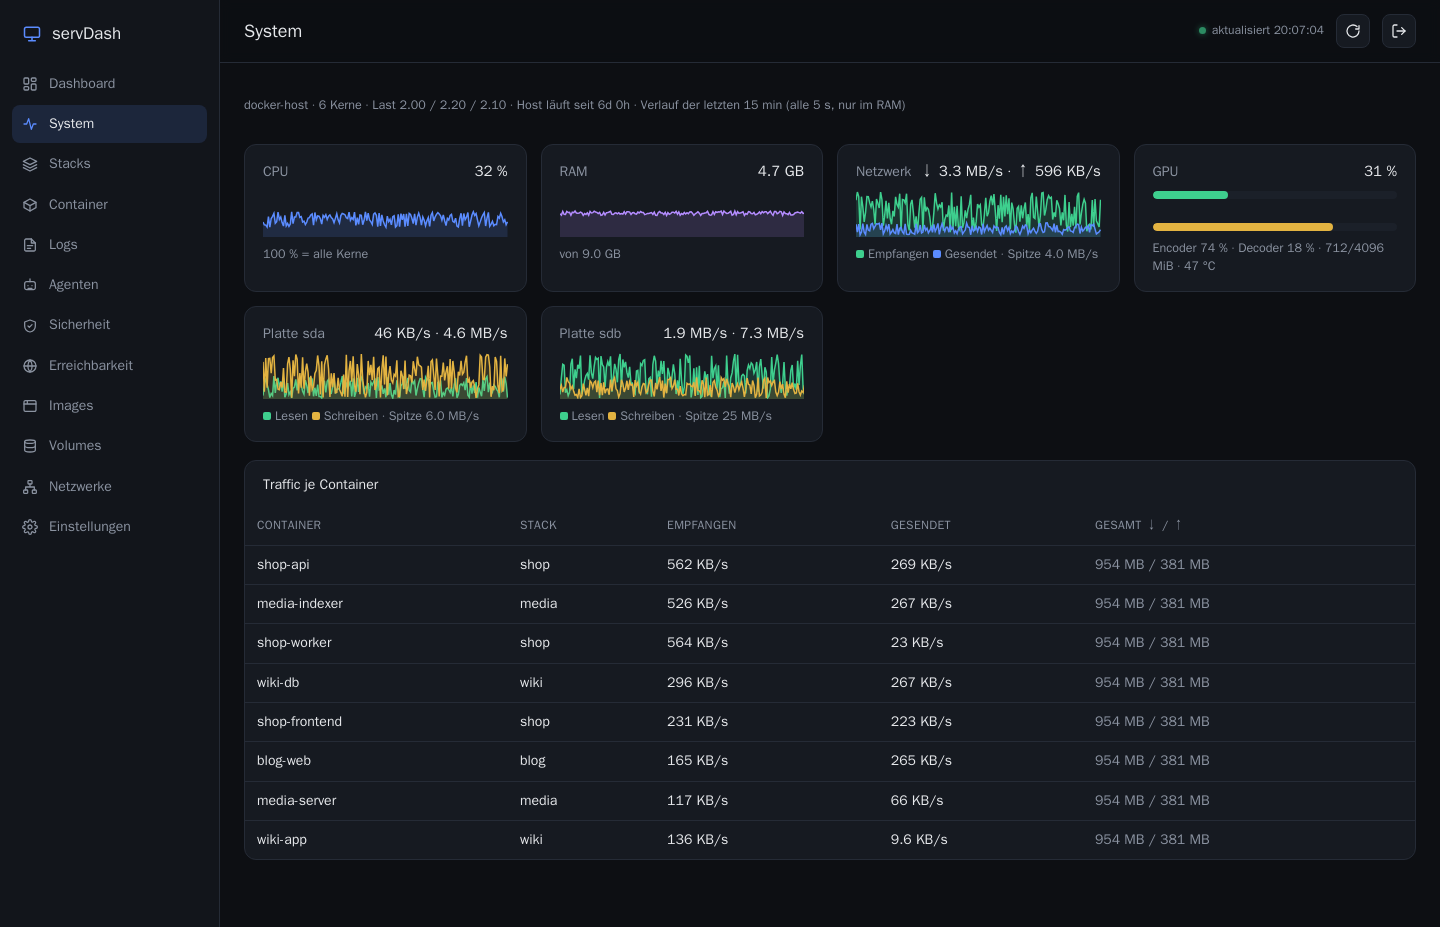
Echtzeit-Zahlen, ohne dafür zu bezahlen. Der naheliegende Weg zu CPU und Speicher pro Container ist docker stats – und der ist erstaunlich teuer: Jeder Aufruf dauert ein bis zwei Sekunden pro Container und hält den Docker-Daemon beschäftigt. Das Dashboard liest stattdessen die cgroup-Zähler direkt aus dem Dateisystem – eine Handvoll winziger Dateizugriffe pro Container – und schickt alle zwei Sekunden Updates per Server-Sent Events an den Browser, aber nur, solange jemand zuschaut.
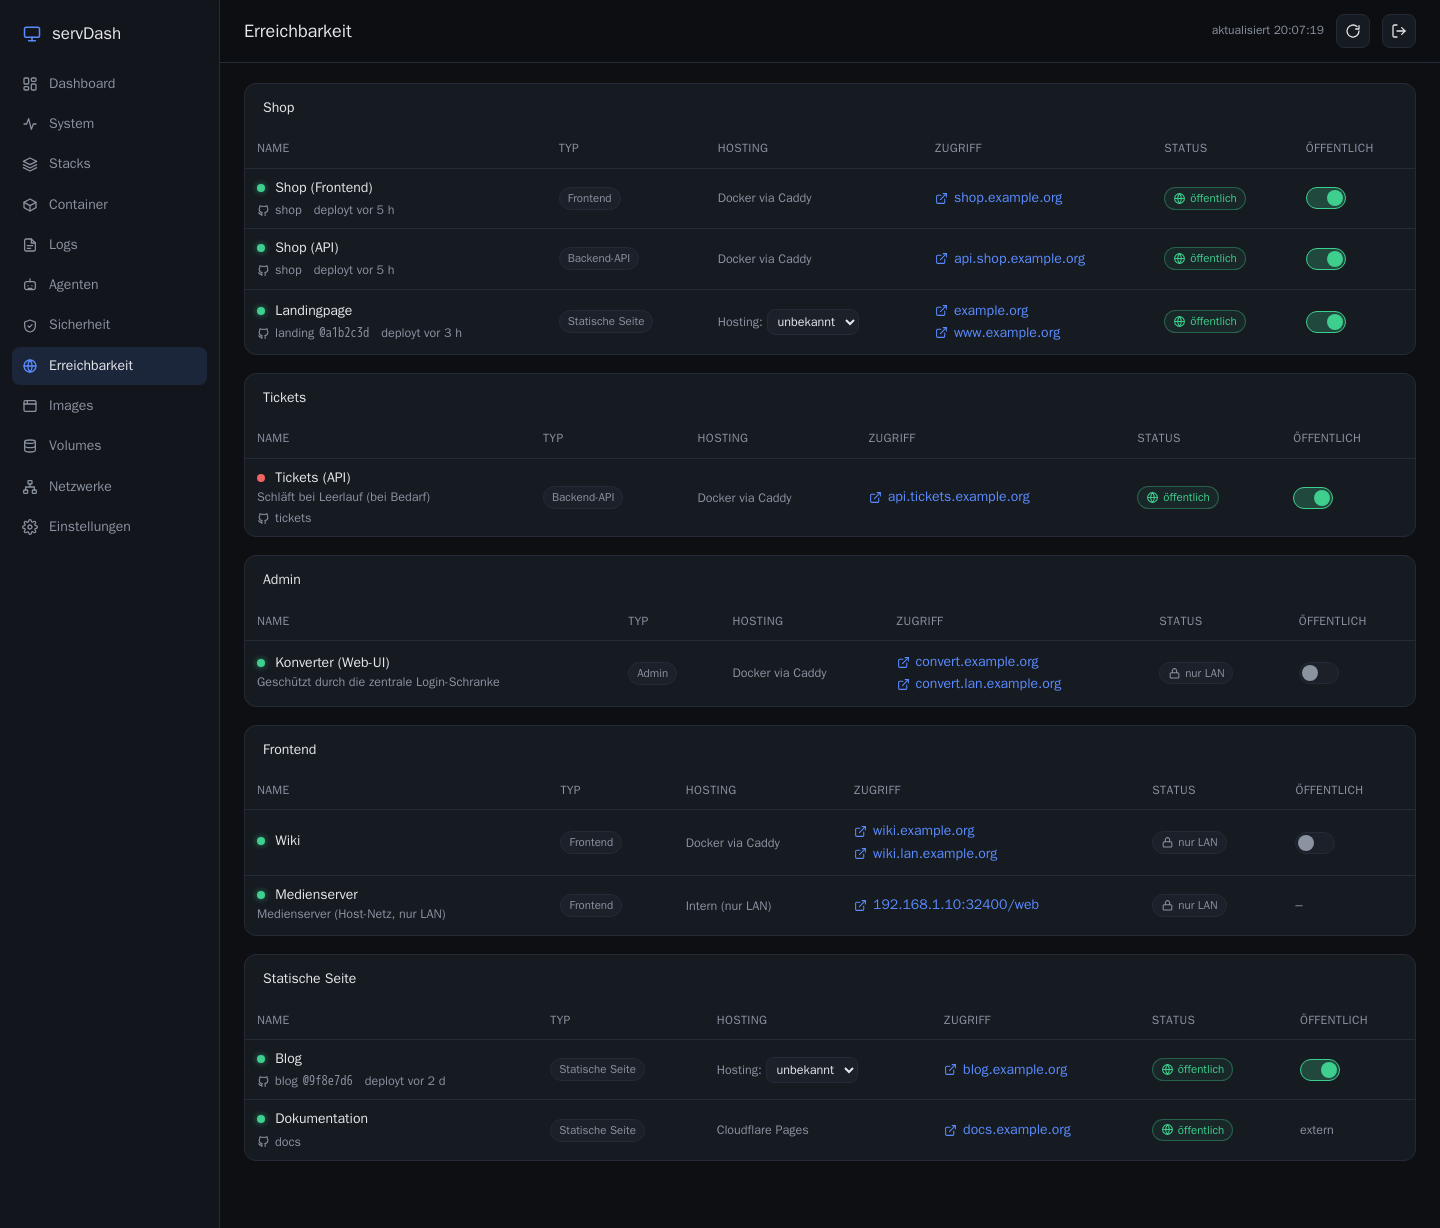
Ein Ort für „was ist erreichbar“. Docker-Apps hinter dem Reverse Proxy, statische Seiten, externe Seiten, interne Dienste – jeweils mit Typ, öffentlich oder nur LAN, Zugriffsweg, Repo und letztem Deploy. Öffentlich/privat ist ein Schalter; nach dem Umlegen fragt das Dashboard von außen so lange nach, bis der neue Zustand bestätigt ist, statt nur darauf zu hoffen.
Backends, die schlafen, bis sie gebraucht werden. Ein Backend aus mehreren Diensten, das ein paar Mal am Tag benutzt wird, muss nicht den ganzen Tag Speicher und CPU belegen. Ein kleiner Proxy im Dashboard nimmt die Anfragen entgegen, startet den Stack, falls er schläft, hält die Anfrage fest, bis die Dienste antworten, und leitet sie dann weiter – ohne Timeouts, WebSockets inklusive. Nach einer einstellbaren Leerlaufzeit schläft der Stack wieder ein. Ich habe einen Kaltstart von etwa 34 Sekunden für fünf Java-Dienste gemessen; die erste Anfrage wartet einfach so lange und gelingt. Wichtige Details: Health-Checks externer Monitore zählen nicht als Aktivität (und der Proxy beantwortet sie, solange der Stack schläft), und ein Aktivitätsschutz hält einen Stack wach, solange seine Container arbeiten – auch ohne HTTP-Verkehr.
Eine Login-Schranke für Apps ohne Login. Manche Werkzeuge (eine Konverter-Oberfläche, ein Download-Client) haben gar keine Authentifizierung. Ein einziger Reverse-Proxy-Baustein – forward_auth gegen das Dashboard – stellt sie hinter einen gemeinsamen Login, domainweit und mit sicherer Weiterleitung zurück dorthin, wo man herkam.
Agenten, die Logs lesen und CVEs jagen. Das ist der Teil, der mir am besten gefällt:
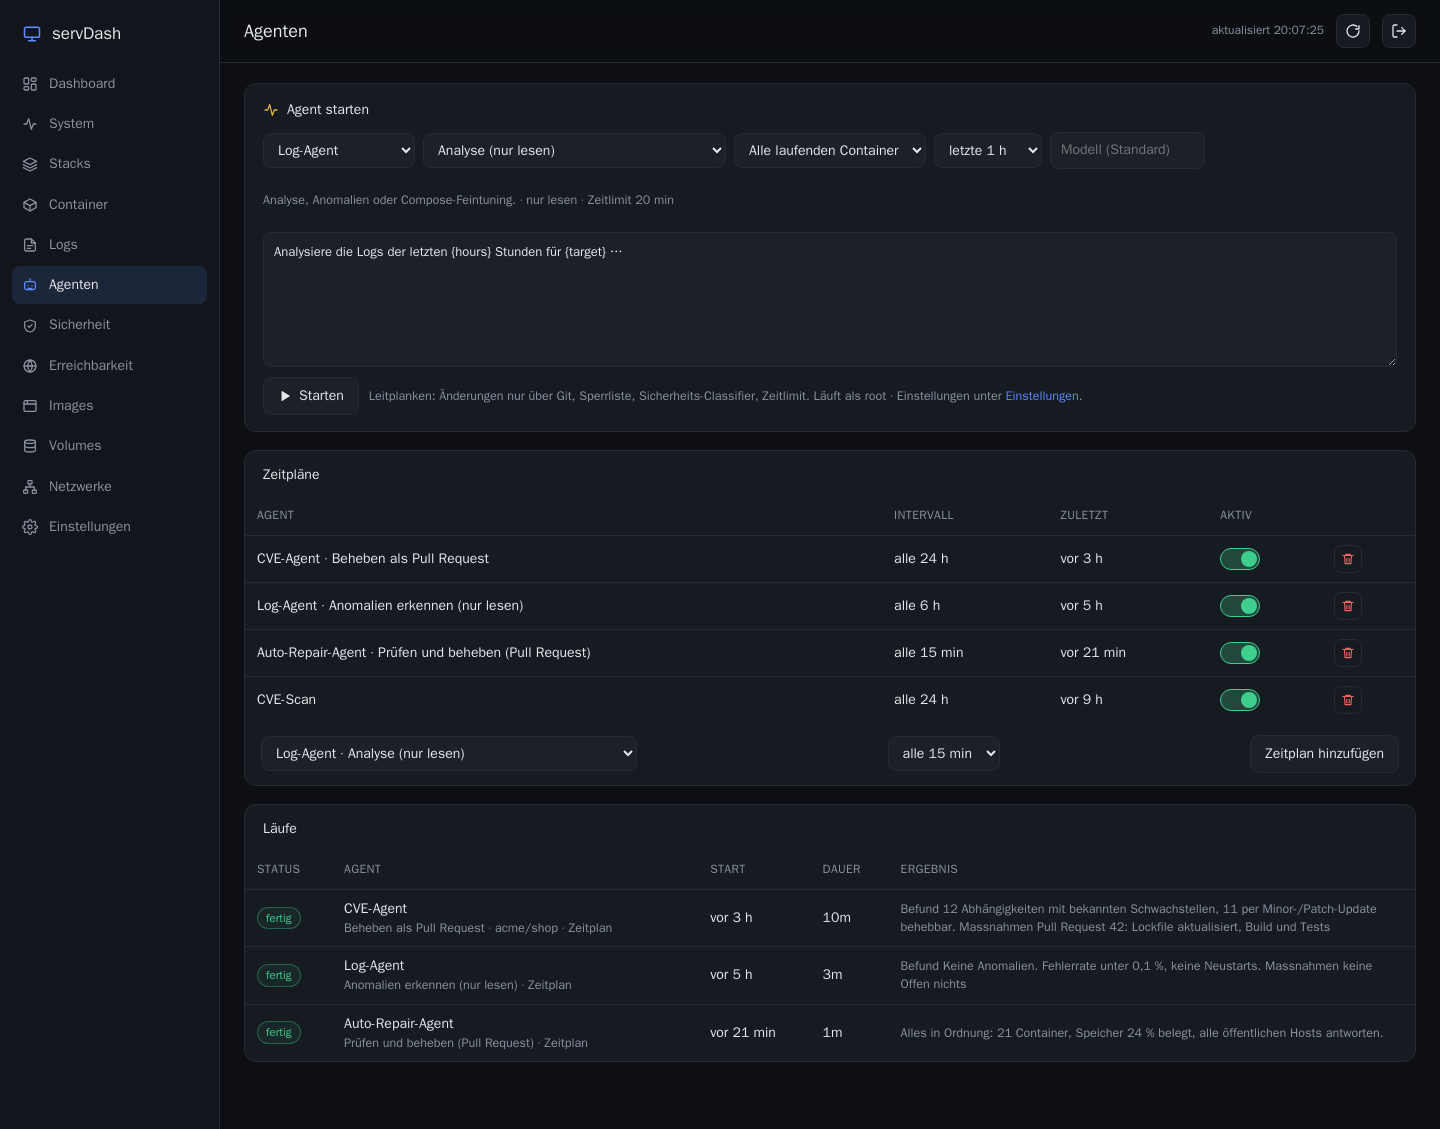
- Der Log-Agent kann Logs analysieren, nach Anomalien suchen (im Vergleich mit den Stunden davor) oder die Docker-Compose-Dateien anhand echter Messwerte feintunen und Änderungen als Pull Request vorschlagen.
- Der CVE-Agent arbeitet mit Trivy-Scan-Ergebnissen und hat vier Modi: nur finden, Triage (wird das verwundbare Paket zur Laufzeit überhaupt genutzt?), als Pull Request beheben oder direkt auf den Standard-Branch beheben nach grünem Build. Vor einem Modus, der etwas ändert, prüft er, ob GitHub erreichbar und beschreibbar ist – andernfalls wird der Lauf still auf „nur lesen“ herabgestuft.
- Alles ist in der Oberfläche konfigurierbar: Modi, Modell, Zeitlimit, Aufträge (Vorlagen mit Platzhaltern), Repositories, Zeitpläne und sogar das Befehls-Präfix, mit dem Docker erreicht wird – damit dasselbe Setup auf einem anderen Rechner läuft.
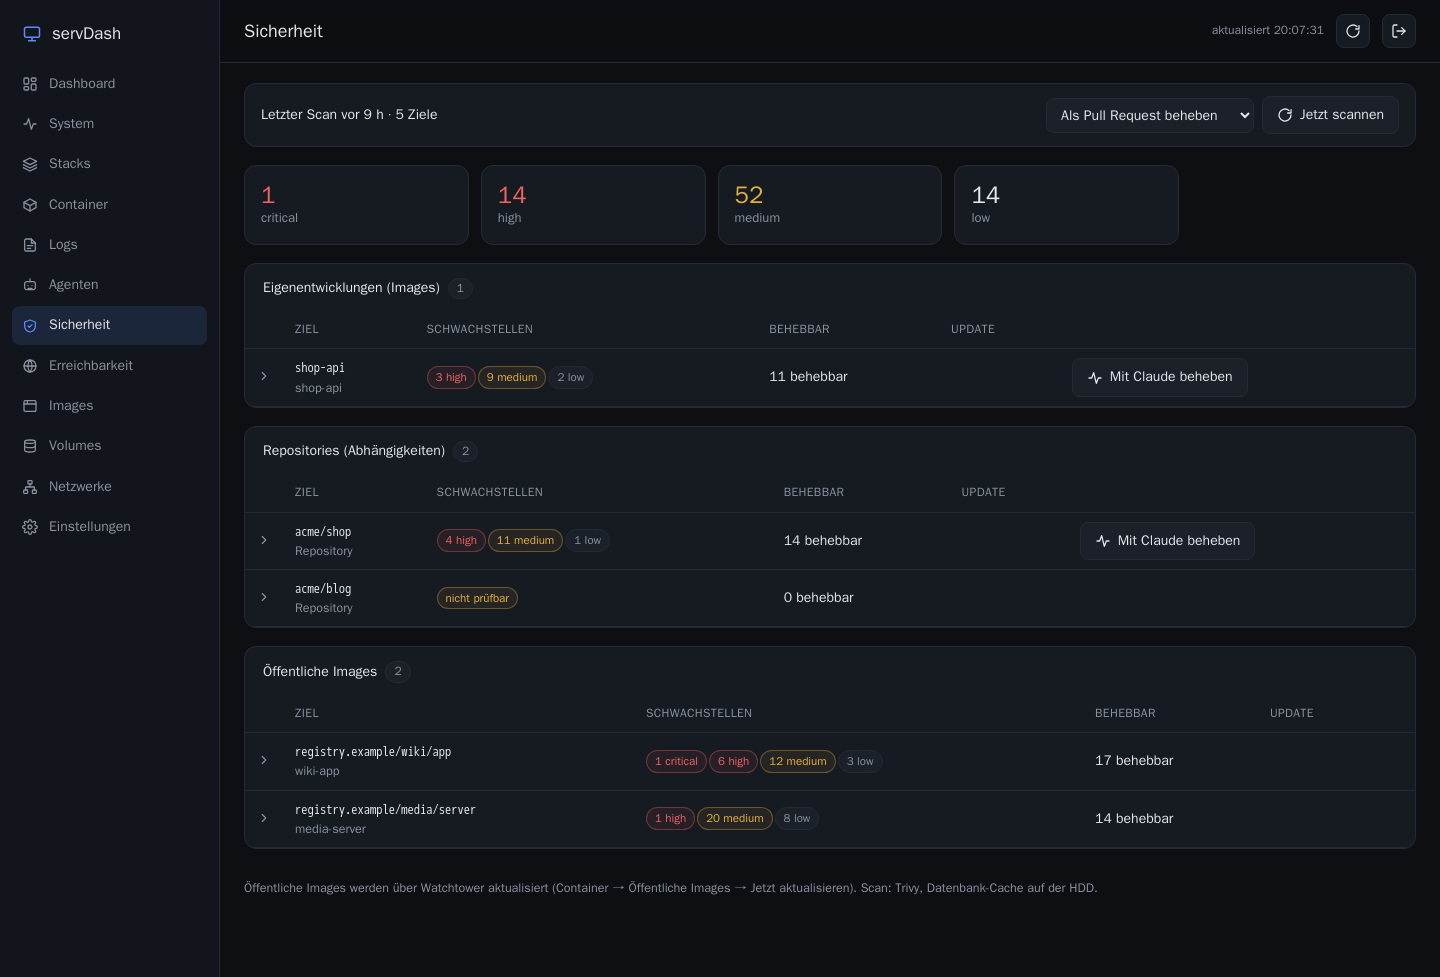
Ein echtes Beispiel, warum der Triage-Modus sich lohnt: Bei einer älteren React-Seite meldete der Scanner 79 kritische und hohe Befunde, drei davon kritisch. Der Agent las den Code und das Build-Setup und stufte fast alle als Build- oder Dev-Werkzeug ein, das nie in einen Browser ausgeliefert wird – Gesamtrisiko gering – und nannte die wenigen Fixes, auf die es wirklich ankommt. Genau diesen Bericht hätte ich mir von einem Kollegen gewünscht – geliefert in Minuten.
(Wie ich solche Agenten in ihrer Spur halte, behandelt der vorige Beitrag.)
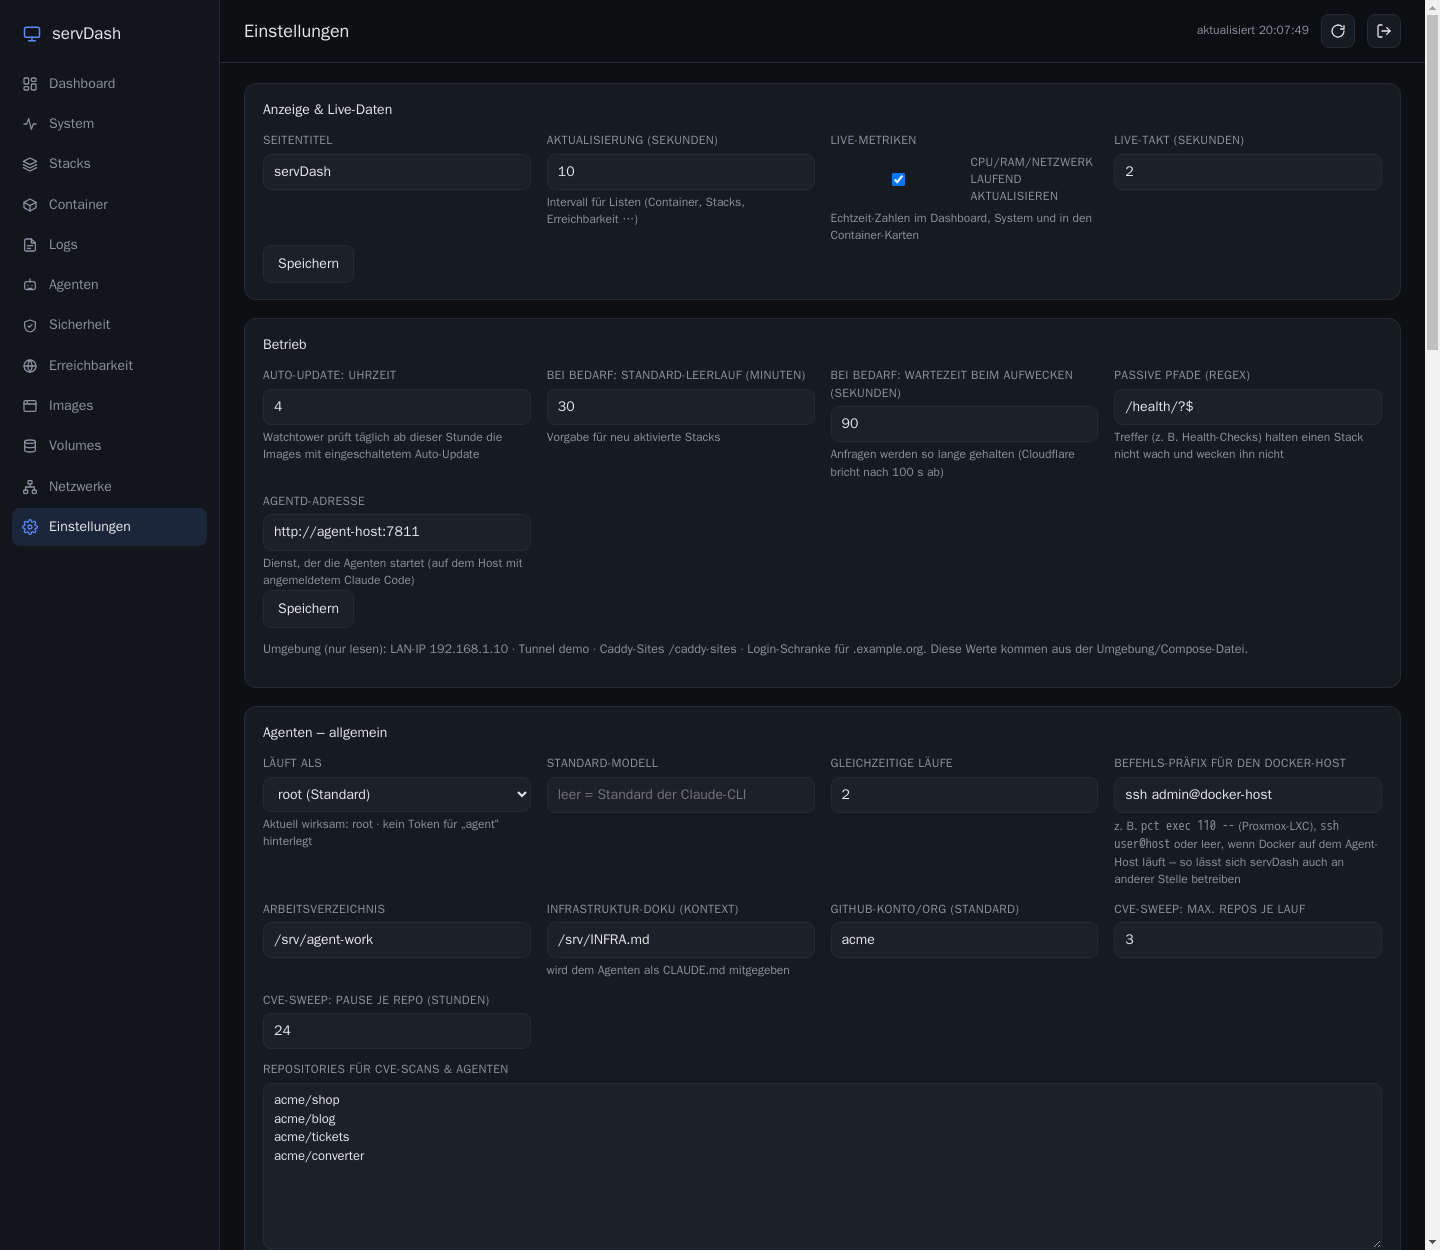
Einstellungen für alles. Aktualisierungsintervalle, Live-Metriken, Auto-Update-Uhrzeit, Schlaf-Vorgaben, Agentenverhalten – eine Seite, keine Code-Änderungen.
Wie ich mit der KI gearbeitet habe
Für das Dashboard habe ich kaum einen Editor angefasst. Der Ablauf sah so aus:
- Das Ergebnis in normalen Sätzen beschreiben, auch die lästigen Teile („es darf nicht in einen Timeout laufen, während das Backend startet“), und die KI zuerst eine kurze Spezifikation in die
AGENTS.mddes Repos schreiben lassen. - Die KI in kleinen Schritten bauen lassen – committen, pushen, per CI deployen und dann live verifizieren: mit
curleinloggen, die neuen Endpunkte aufrufen, die Antwortform prüfen, die Tests laufen lassen. „Es kompiliert“ galt nie als fertig. - Parallele Agenten für unabhängige Arbeit. Für die größere Sitzung hinter diesem Beitrag liefen sechs Sub-Agenten gleichzeitig – Speicher und Migrationen, CVE-Fixes, der Reverse Proxy, die Blog-Struktur, Hosting-Schalter, eine Medien-Pipeline –, jeder mit derselben Briefing-Datei (den Regeln: alles über Git, keine Geheimnisse in Ausgaben, vor dem Melden verifizieren) und eigenem Code-Bereich.
- Eine einzige Quelle für Kontext: eine
AGENTS.md, die jeder Agent lädt. Sie ist langweilig, und sie ist der Grund, warum die Agenten nicht dieselben Erkenntnisse immer wieder neu entdecken.
Was schiefging (und was ich gelernt habe)
- Das Dashboard sagte „öffentlich“ bei etwas Privatem. Der Status wurde daraus abgeleitet, in welchem Ordner eine Konfigurationsdatei liegt – und ein Deploy aus Git legte die Datei still wieder zurück. Die Lösung: Maßgeblich ist die Tunnel-Regel, also das, was tatsächlich erreichbar ist, nicht das, was eine Datei behauptet. Zustand aus der Wirklichkeit ableiten.
- „Das Dashboard ist langsam“ lag nicht am Dashboard. Drei Videokonvertierungen und mehrere parallele Builds hatten eine einzelne langsame Festplatte gesättigt (ein Plattentest zeigte etwa 8 dauerhafte Schreibvorgänge pro Sekunde gegenüber 444 auf der SSD). Die Lösungen: Datenbanken auf die SSD, schwere Jobs mit einer Sperre serialisiert, CPU-Deckel für den Konverter und Stale-while-revalidate-Caching mit Aufwärmen im Hintergrund, damit die Oberfläche nie auf eine teure Abfrage wartet.
- Das Verschieben des Container-Speichers bei laufenden Containern ließ sie in den alten, gelöschten Pfad schreiben. Uploads scheiterten etwa eine Stunde lang; der Log-Agent brachte das Symptom ans Licht, und die Ursache war mein eigener Speicherumzug. Lehre: Nach einer Migration mit einem Schreibtest prüfen, nicht mit
ls. - Selbst die Screenshots brauchten einen Umweg. Das
--screenshotvon Headless-Chrome lieferte bei einer Seite mit Live-Ereignisstrom leere Bilder; den Browser über sein DevTools-Protokoll zu steuern löste das – und lieferte als Bonus bessere Bilder in voller Höhe.
Was sich zum Abschauen lohnt
- Keine Datenbank. JSON-Dateien neben dem Container reichen für Einstellungen und Schlafzustand und machen das Ganze trivial umziehbar.
- Git ist die Quelle der Wahrheit für Konfiguration; die Wirklichkeit ist die Quelle der Wahrheit für Zustand.
- Billig messen. Lesen, was der Kernel ohnehin zählt.
- Würdevoll ausfallen. Ist GitHub nicht erreichbar, berichtet der Agent trotzdem; ist die Tunnel-API nicht erreichbar, sagt der Status „unbekannt“, statt zu lügen.
- Die KI für die Verifikation einsetzen, nicht nur für den Code. Die wertvollsten Agentenläufe waren die, die andere Arbeit geprüft haben.
Das Dashboard ist (noch) nicht Open Source und stark auf mein eigenes Setup zugeschnitten. Aber die Bausteine – cgroup-basierte Metriken, ein Aufweck-Proxy, der Anfragen festhält, ein forward_auth-Gate, modusbasierte Agenten mit GitHub-Vorprüfung – sind klein genug, um sie an einem Nachmittag selbst zu bauen. Heute hat mich daran erinnert, wie kurz „ein Nachmittag“ geworden ist.
