Neu im selbstgebauten Dashboard: Zweisprachig, sicherere Agenten, Auto-Scans
Einen Tag nachdem ich mein eigenes Portainer samt Agenten gebaut habe, hat sich am Dashboard schon viel getan. Ein Werkzeug jeden Tag zu benutzen ist der schnellste Weg herauszufinden, was fehlt, und das meiste hier kam aus kleinen Ärgernissen: ein Browser-Dialog, der zu wenig fragte, ein Scan-Ergebnis, das still veraltet war, ein Screenshot, den ich nicht zeigen konnte. Dieser Beitrag ist der Nachtrag: was neu ist, warum, und was ich gelernt habe. Wie zuvor stammen alle Screenshots aus einem Demo-Modus mit erfundenen Daten. Die Namen darin sind ausgedacht.
1. Eine zweisprachige Oberfläche
Die Oberfläche wechselt per Umschalter in der Kopfzeile (auf jedem Screenshot oben rechts) zwischen Deutsch und Englisch.
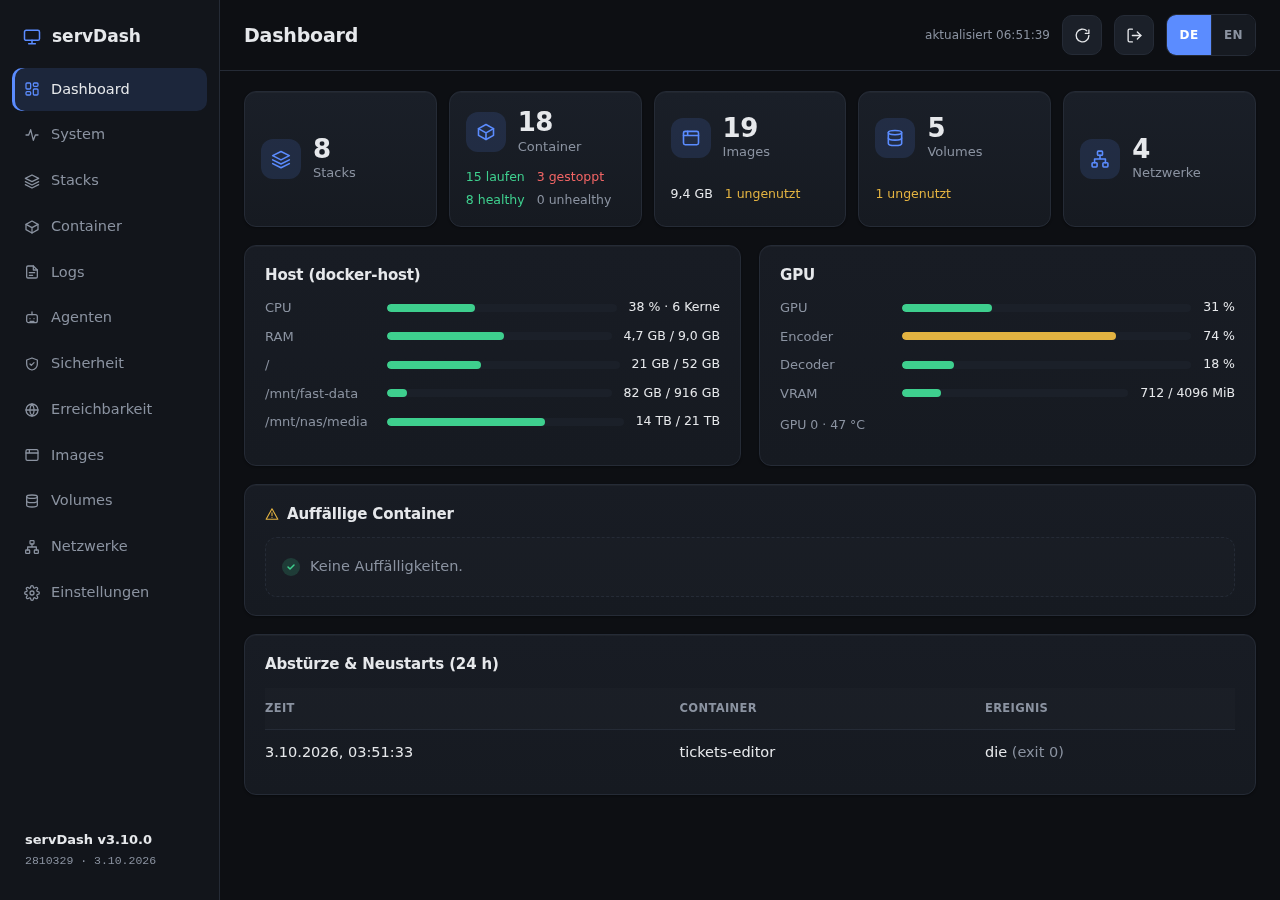
Ich habe das ohne i18n-Framework gebaut. Es gibt ein Wörterbuch aus Schlüsseln pro Sprache und eine Nachschlage-Funktion. Entscheidend ist ein Test: Er geht alle im Code verwendeten Schlüssel durch und schlägt fehl, wenn eine Sprache einen Schlüssel hat, den die andere nicht kennt, oder wenn ein Schlüssel benutzt, aber nirgends definiert wird. Eine fehlende Übersetzung ist ein stiller Fehler: Nichts stürzt ab, man sieht sie nur, wenn man zufällig die Sprache wechselt. Ein Test, der beide Wörterbücher vergleicht, kostet fast nichts und fängt genau das ab.
Auch Datum und Zahlen folgen der Sprache (4,7 GB gegenüber 4.7 GB).
2. Beschreibungen und Einmal-Container
Ein Dashboard mit 18 Containern sollte sagen, wofür sie da sind. Ein Container kann jetzt per Compose-Label beschrieben werden:
labels:
  servdash.description: "Wandelt hochgeladene Dateien im Hintergrund um"
  servdash.oneshot: "true"
Die Beschreibung erscheint in der Oberfläche. Das zweite Label ist wichtiger, als es aussieht. Manche Container sollen laufen, fertig werden und sich beenden: eine Migration, ein Index-Aufbau, ein Job, den ein Scheduler startet. Ohne Zusatzinfo sieht das Dashboard exited und färbt es rot, wie in der Demo unten. In der Liste „Auffällige Container“ ist das Rauschen, und Rauschen lehrt einen, die Liste zu ignorieren. Mit oneshot gilt ein Ende mit Exit-Code 0 als erwartet und wird nicht gemeldet. Ein Ende mit Fehlercode bleibt auffällig.
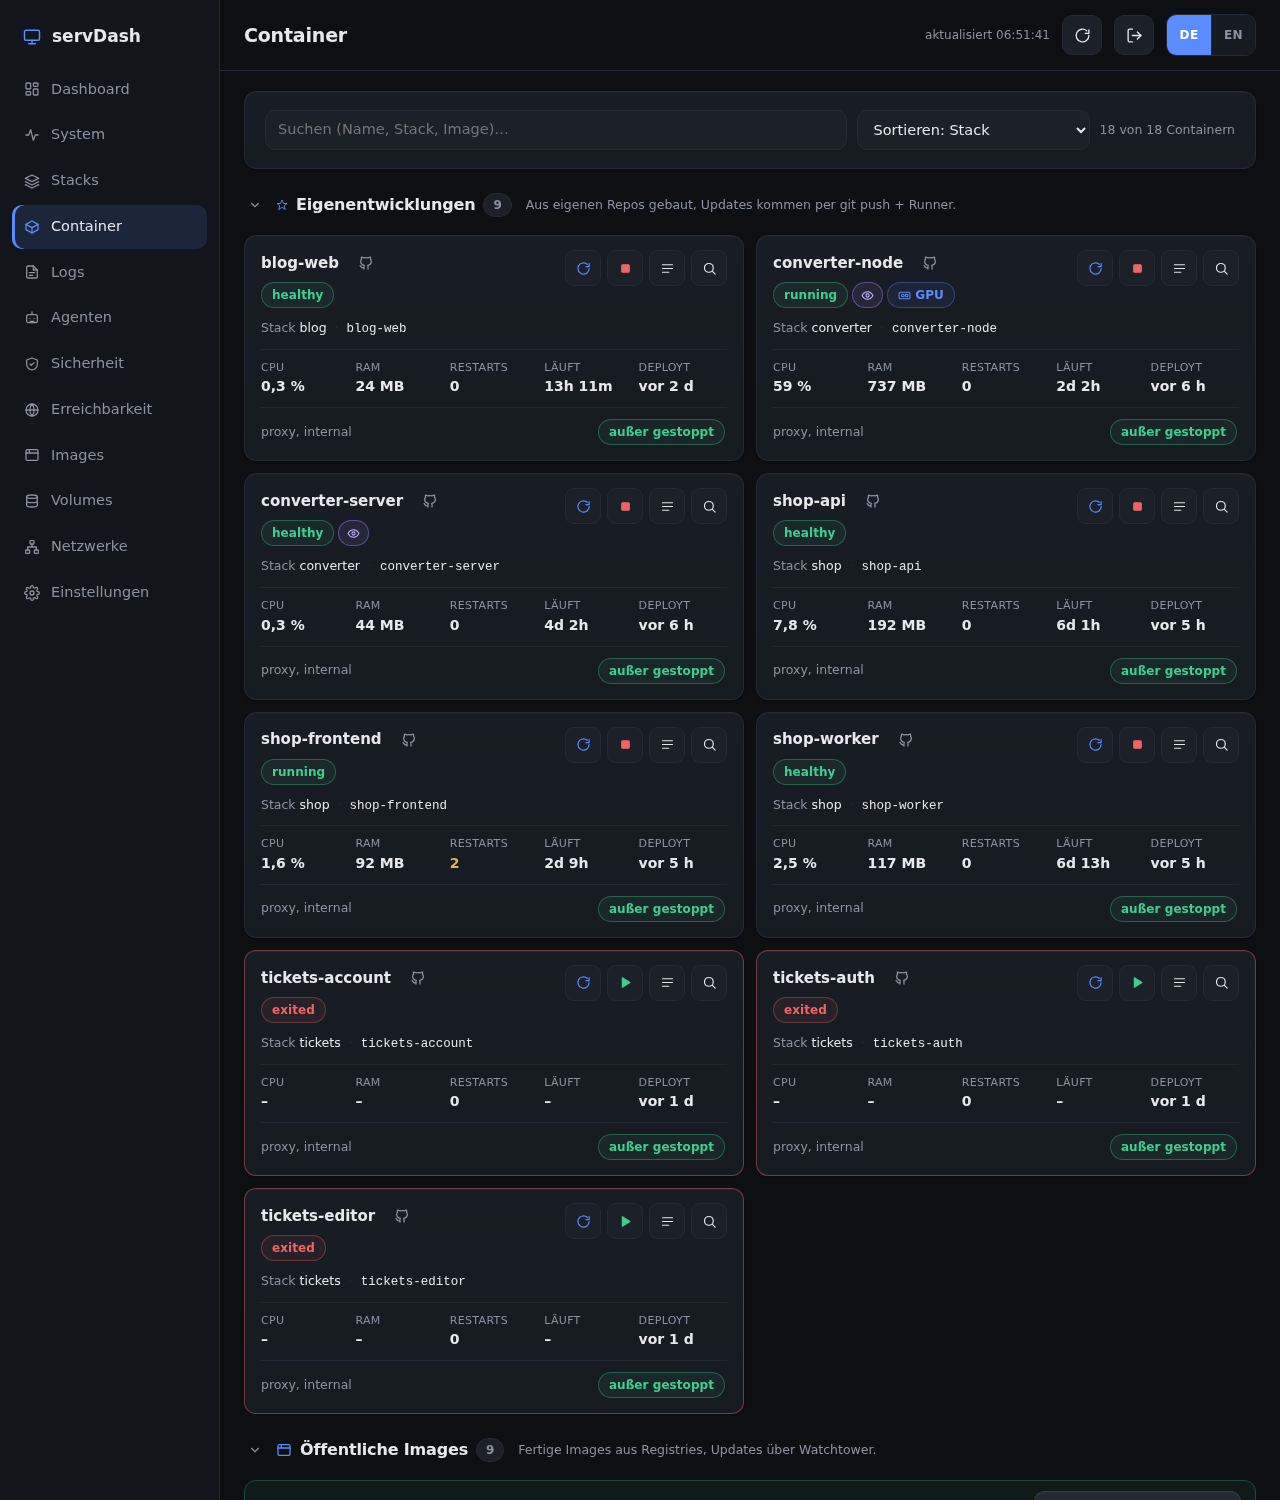
Ehrlich zu diesem Screenshot: Die drei roten tickets-*-Container sind genau der Fall, für den das Label gedacht ist. Sind es Batch-Jobs, markiert man sie, und das Rot verschwindet. Sind es Dienste, ist Rot richtig.
3. Ein richtiger Dialog statt confirm()
Einen Agenten zu starten war ein Browser-confirm(): OK oder Abbrechen. Das ist zu wenig für etwas, das Code ändern kann. Der neue Dialog fragt, worauf es ankommt:
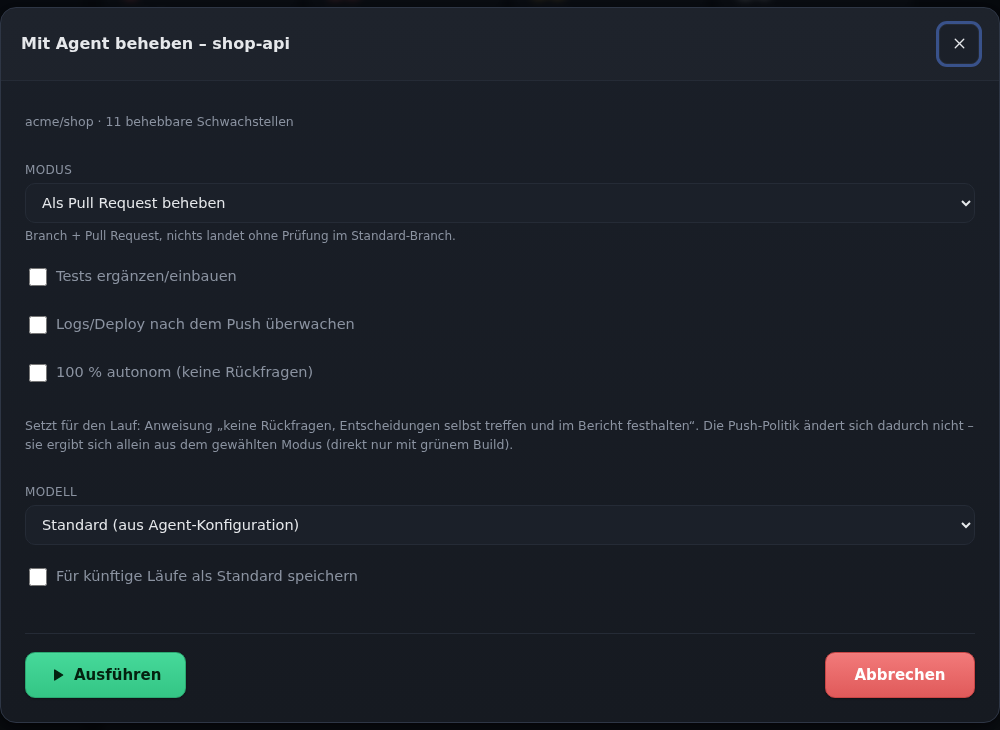
- Modus: nur melden, Triage, als Pull Request beheben oder direkt im Standard-Branch beheben.
- Checkboxen: Tests ergänzen, Logs und Deploy nach dem Push überwachen.
- 100 % autonom: Der Agent bekommt die Anweisung, keine Rückfragen zu stellen, selbst zu entscheiden und die Entscheidungen im Bericht festzuhalten.
- Modell und als Standard speichern für künftige Läufe.
Der Satz unter „autonom“ ist der wichtige: Die Push-Politik ändert sich dadurch nicht. Autonomie entscheidet nur, ob der Agent nachfragen darf. Ob er in den Standard-Branch pushen darf, ergibt sich allein aus dem gewählten Modus. Und „direkt“ bleibt an zwei Bedingungen geknüpft, die ich im SemVer-Beitrag beschrieben habe: Der Build muss grün sein, und es darf nur ein Minor- oder Patch-Update sein. Ein Major-Sprung ist per Definition ein Breaking Change und geht deshalb immer über einen Pull Request. Ich will einen Agenten, der ohne Aufsicht arbeitet, aber keinen, der sich einreden kann, ein Major-Upgrade zu pushen, nur weil niemand da war, den er fragen konnte.
4. Der „Prüfen“-Schritt für Agenten
Agenten werden durch Prompts und durch das konfiguriert, was sie ausführen dürfen. Beides lässt sich leicht falsch einstellen, deshalb gibt es neben der Agenten-Konfiguration jetzt einen Prüfen-Knopf. Er lässt ein Modell die Einstellung begutachten und liefert vier Dinge:
- Eine Bewertung des Prompts: Ist er klar, enthält er Widersprüche, fehlen Abbruchbedingungen?
- Eine Modellempfehlung mit Kosten: Lohnt sich für die Aufgabe das große Modell, oder reicht ein günstigeres? Die Kosten sind eine Schätzung und werden als Schätzung angezeigt.
- Eine Liste der Befehle, die der Agent voraussichtlich nutzt, jeweils mit Risikostufe.
- Einen Vorschlag für
allowedTools, also die Erlaubnisliste der Befehle, die der Agent ohne Nachfrage ausführen darf.
Nichts davon wird automatisch übernommen. Ein Vorschlag wird erst nach meinem Klick auf „Übernehmen“ wirksam. Ich halte das für die richtige Arbeitsteilung: Das Modell bemerkt gut, dass ein Prompt irgendwo rm -rf zulässt, und ich entscheide, ob das akzeptabel ist. Ein Vorschlag, der Berechtigungen selbst ändert, würde den Sinn der Übung zunichtemachen.
5. Versteckt-Modus für Screenshots, Demos und Streams
Ein Dreifachklick aufs Logo schaltet das Dashboard in den Versteckt-Modus. Alles, was als sensibel markiert ist, verschwindet aus den Listen, und ein durchgestrichenes Auge neben dem Logo zeigt, dass er aktiv ist. Man sieht es im Vergleich der beiden Sicherheits-Screenshots: Der erste hat 7 Ziele, der zweite 6, weil ein markiertes Ziel einfach fehlt.
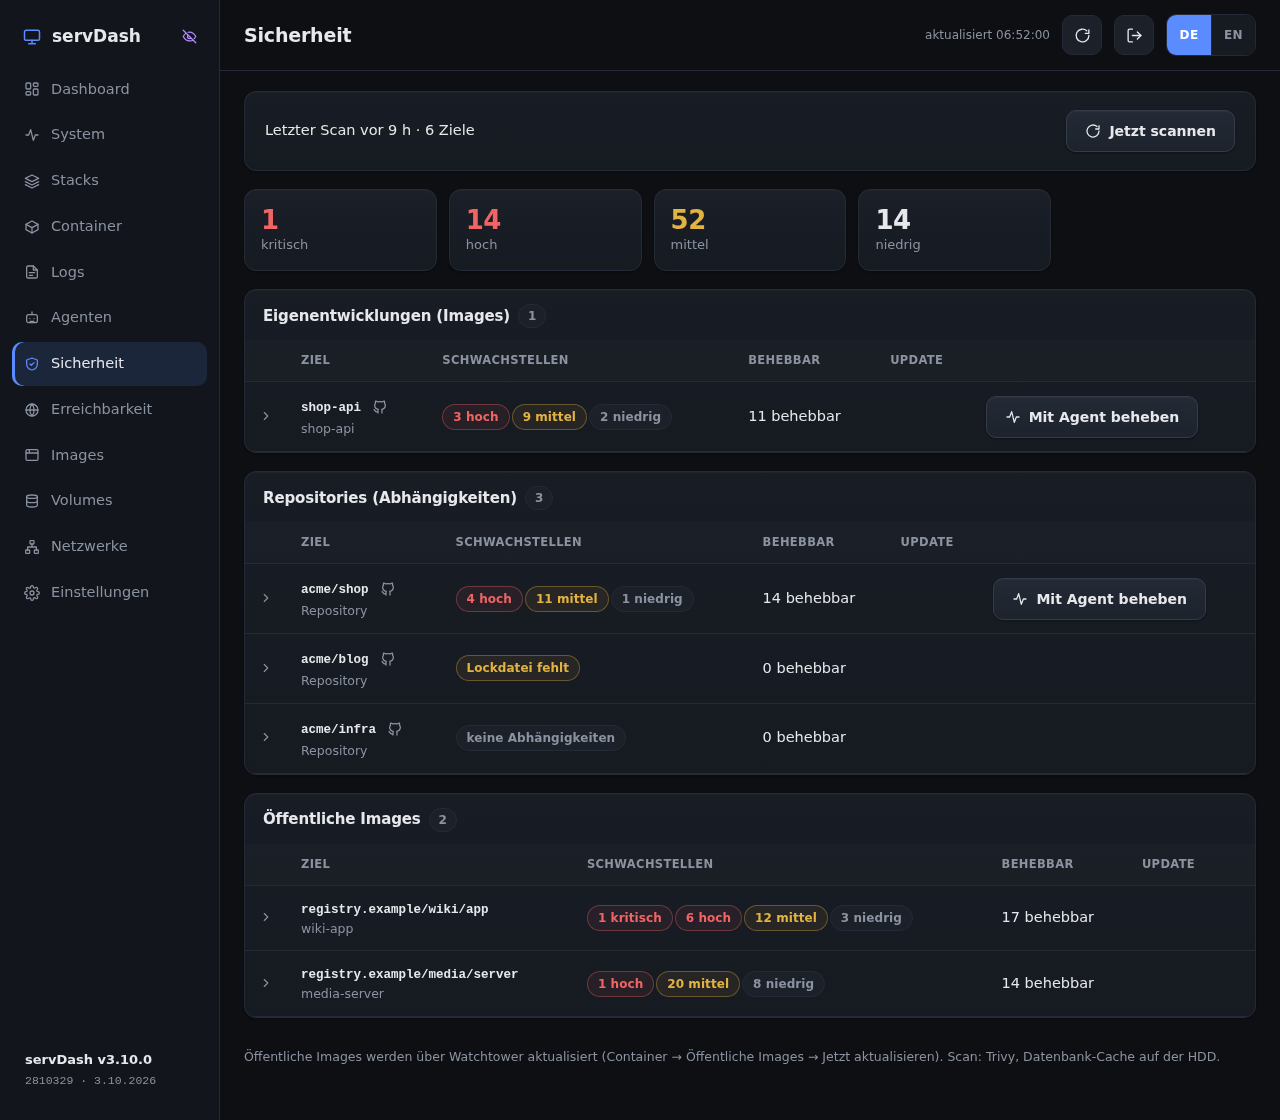
Der Modus ist dafür da, das Dashboard jemandem zu zeigen, einen Stream aufzunehmen oder Screenshots zu machen, ohne vorher jede Zeile zu prüfen. Er ist eine Bequemlichkeit für das Publikum im Raum, keine Sicherheitsfunktion. Wer überhaupt etwas sehen darf, entscheidet weiterhin der Login.
6. Auto-Scan bei neuem Image, und warum der tägliche Scan nicht reicht
Bisher lief der CVE-Scan einmal pro Nacht. Das klingt vernünftig, bis man sieht, was passierte: Ich hatte nach dem Scan mehrere Images neu ausgeliefert, und das Dashboard zeigte weiter den alten Stand. Die Zahlen waren nicht falsch, sie waren veraltet, und eine Sicherheitsübersicht, die den Stand von gestern zeigt, wiegt einen genau dann in falscher Sicherheit, wenn man gerade etwas geändert hat.
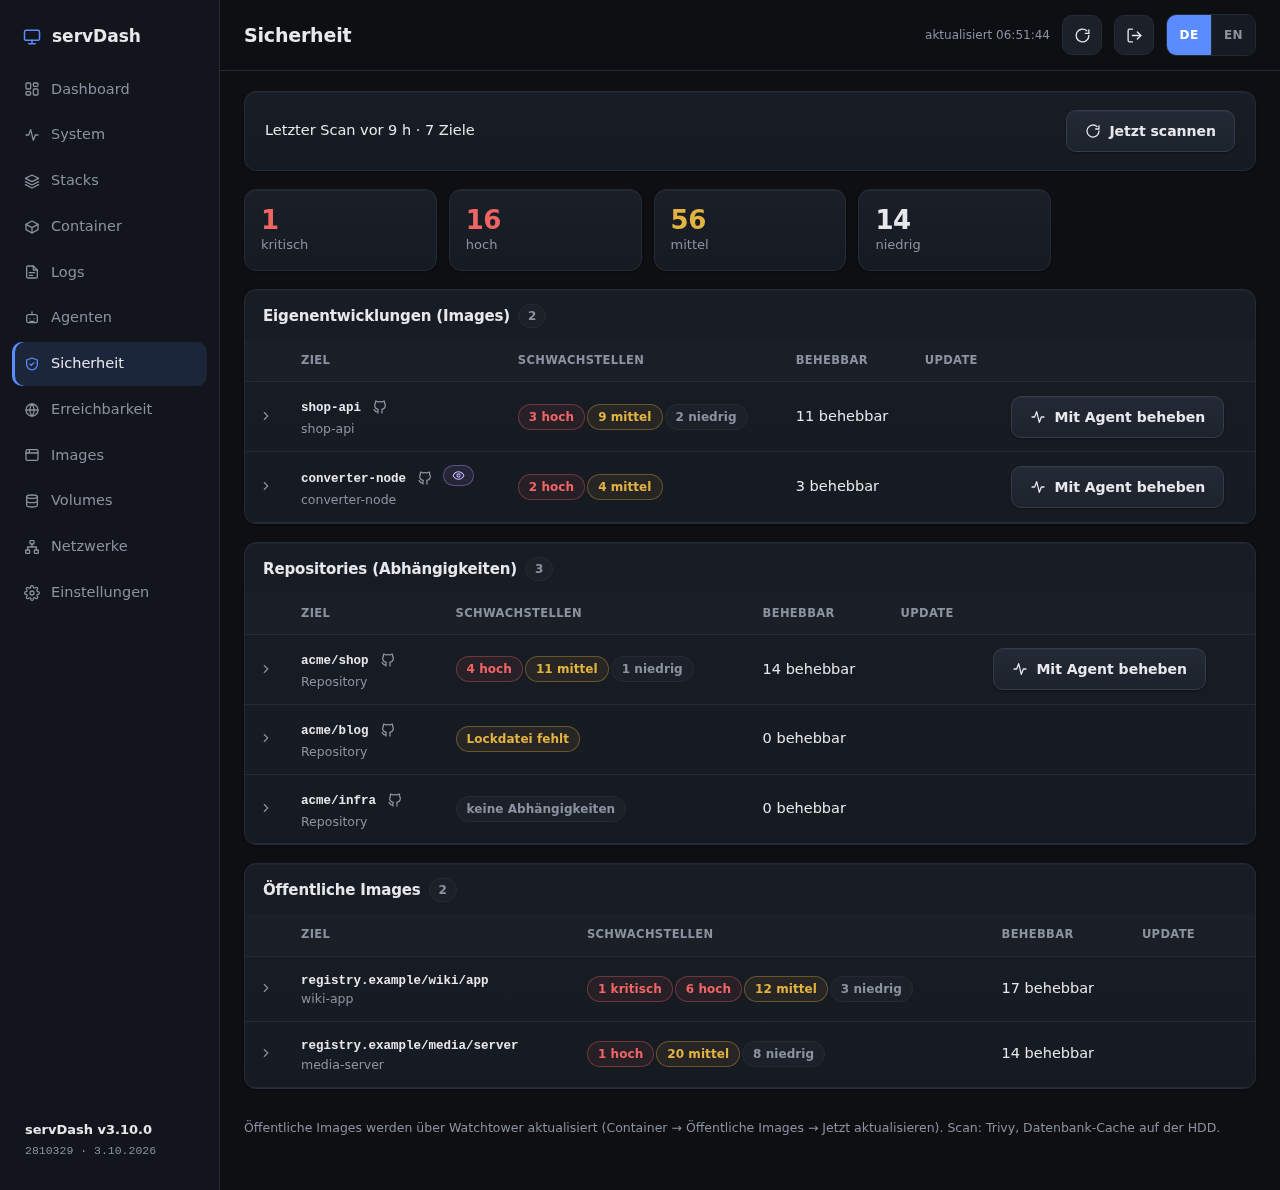
Jetzt hört das Dashboard auf Docker-Events. Wird ein Image gebaut oder ein Container aus einem neuen Image gestartet, wird ein Scan angesetzt. Drei Details machen das praxistauglich:
- Entprellen: Ein Deployment mit fünf Diensten erzeugt einen Schwall von Events. Der Scan wartet, bis es kurz ruhig ist, und läuft dann einmal.
- Eine Warteschlange: Scans sind schwer, und der Host mag keine parallele Schwerlast. Anfragen werden nacheinander abgearbeitet.
- Der nächtliche Scan bleibt. Events decken Änderungen ab, die ich mache. Sie decken nicht ab, dass für ein unverändertes Image neue Schwachstellen bekannt werden. Dafür ist der tägliche Lauf da.
7. Ein blinder Fleck bei Frontend-Findings
Ein kleinerer Befund mit echter Konsequenz: Ein gebautes Frontend-Image zu scannen sagt kaum etwas. Das Bundle im Image enthält kompiliertes JavaScript, aber keine package.json und keine Lock-Datei, der Scanner findet also keine Manifeste. Das Ergebnis sieht sauber aus und ist nur leer. Deshalb scannt die Übersicht zusätzlich Repositories (Tabelle „Repositories (Abhängigkeiten)“) und zeigt ein Repository ohne eingecheckte Lock-Datei als „Lockdatei fehlt“ statt „0 Findings“. Ein ehrliches „nicht prüfbar“ ist besser als eine grüne Null.
8. Eine Version in der Seitenleiste
Unten in der Seitenleiste zeigt das Dashboard seine eigene Version, einen kurzen Commit-Hash und das Datum. Es folgt SemVer, im Sinne des oben verlinkten Beitrags. Das klingt nebensächlich, aber wenn ich einen Screenshot oder einen Fehlerbericht sehe, will ich in einer Sekunde wissen, aus welchem Build er stammt.
9. Ausblick (geplant, nicht gebaut)
Das sind Pläne, nichts davon existiert bisher:
- Backups und Snapshots, einschließlich des Einspielens eines Server-Abbilds aus dem Dashboard.
- Datenbank-Backup und -Restore pro Tabelle, damit ich eine einzelne Tabelle zurückholen kann, ohne die ganze Datenbank zurückzurollen.
Das Zurückspielen ist die gefährliche Richtung, deshalb rechne ich mit derselben Sorgfalt wie bei den Agenten: Vorschau, was überschrieben wird, ausdrückliche Bestätigung und ein Rückweg.
Lessons learned
- Eine fehlende Übersetzung ist ein stiller Fehler. Ein Schlüsseltest zwischen den Sprachdateien ist billig und fängt sie ab.
- „Exited“ ist nicht immer ein Fehler. Kann ein Werkzeug einen fertigen Job nicht von einem Absturz unterscheiden, wird die Warnliste zu Rauschen.
- Autonomie und Berechtigung sind verschiedene Regler. „Frag mich nicht“ darf nicht „du darfst alles pushen“ heißen.
- Das Modell schlägt vor, der Mensch übernimmt. Besonders bei Erlaubnislisten.
- Eine Sicherheitsübersicht muss ihre Aktualität zeigen. Scans bei Änderungen auslösen, den periodischen Lauf für alles Äußere behalten.
- Ein leeres Ergebnis kann „nicht geprüft“ heißen. Diesen Unterschied sichtbar machen.
- Den Demo-Modus früh bauen. Er hat jeden Screenshot in diesem Beitrag möglich gemacht, ohne etwas Echtes zu zeigen.
